Aggiornato al 12 agosto 2026 · Tempo di lettura: 20 minuti · Test condotti ad agosto 2026
Scegliere un chatbot AI nel 2026 significa valutare non solo le risposte, ma anche ricerca web, file, continuità tra conversazioni, input visivi e integrazioni. Per capire quale conviene usare abbiamo confrontato le versioni gratuite di ChatGPT, Gemini, Claude, Microsoft Copilot e Perplexity in quattro test pratici, affiancando i risultati alla documentazione ufficiale.
Non esiste un chatbot migliore per tutto: nel nostro campione ChatGPT è stato il più consistente, Gemini il più convincente nella prova visuale e ChatGPT con Perplexity nella riorganizzazione degli appunti. Claude offre funzioni estese per documenti e continuità, mentre Copilot acquista più senso in Microsoft 365. (Claude; Microsoft Copilot) La scelta dipende soprattutto dal lavoro quotidiano.
In breve
| Se cerchi soprattutto… | Chatbot da considerare per primo | Perché |
|---|---|---|
| Un assistente versatile per attività diverse | ChatGPT | È stato il più consistente nei quattro test e riunisce ricerca, file, analisi dati e funzioni visive |
| Immagini, video, audio e servizi Google | Gemini | Ha un ampio perimetro multimodale e ha ottenuto il miglior risultato nel test visuale |
| Documenti lunghi e lavoro continuativo | Claude | È orientato a documenti, contesto e workflow professionali |
| Word, Excel, PowerPoint e Outlook | Microsoft Copilot | Il vantaggio principale è l’integrazione con Microsoft 365 |
| Ricerca web con fonti come attività principale | Perplexity | Ricerca e citazioni sono al centro del prodotto |
Le caratteristiche di prodotto della tabella sono state ricontrollate l’11 agosto 2026 sulle fonti ufficiali: ChatGPT, Gemini, Claude, Microsoft Copilot e Perplexity.
Come abbiamo scelto e confrontato i chatbot
ChatGPT, Gemini, Claude, Microsoft Copilot e Perplexity rappresentano cinque usi diversi: assistente trasversale, lavoro multimodale, gestione di documenti, produttività in una suite aziendale e ricerca web. Il confronto separa i risultati dei test, osservati nelle quattro prove Volvren, dalle caratteristiche dei prodotti, ricavate dalla documentazione ufficiale verificata e datata.
Le capacità principali dichiarate dai produttori
| Chatbot | Ricerca web | File e documenti | Immagini e altri media | Memoria e continuità | Ecosistema più rilevante |
|---|---|---|---|---|---|
| ChatGPT | Sì, anche nel Free | Upload di file e analisi dati nel Free | Immagini in input e generazione nel Free | Memoria disponibile; capacità e rollout possono variare per piano/account | Ambiente generalista, app e servizi collegabili |
| Gemini | Può mostrare fonti web e usa Google Search nelle esperienze di ricerca | Documenti, fogli, codice e file da Drive | Immagini, video e audio | Memoria delle chat su account personali idonei con impostazioni richieste | Gmail, Drive, Docs, Calendar, Keep, Tasks e altri servizi Google |
| Claude | Ricerca web disponibile | Upload di documenti e immagini; creazione di DOCX, XLSX, PPTX e PDF tramite code execution | Analizza immagini e può creare grafici/visualizzazioni | Memoria disponibile anche nel Free | Google Workspace, connettori, workflow su file; Claude Code nei piani a pagamento |
| Microsoft Copilot | Risposte aggiornate basate sulla ricerca web | PDF, DOCX, XLSX, PPTX e altri formati supportati | Immagini in upload e creazione immagini da account idonei | Cronologia delle conversazioni per gli utenti connessi | Microsoft 365, Windows ed Edge |
| Perplexity | È il centro dell’esperienza | Upload limitati nel Free, più ampi nei piani superiori | Supporta immagini, audio e video come allegati | Le Sessioni mantengono il contesto; Projects aggiunge continuità organizzativa | Ricerca, modelli avanzati e strumenti aggiuntivi nei piani superiori |
La tabella mostra le capacità dichiarate, non la qualità con cui vengono svolte. Supporto alle immagini e citazioni, per esempio, non garantiscono una migliore interpretazione né la correttezza del collegamento tra fonte e testo. Per questo abbiamo aggiunto quattro prove pratiche.
Come abbiamo svolto i quattro test
Condotti nell’agosto 2026, i test simulano quattro attività: ricerca aggiornata, riordino di appunti, lettura di una lavagna e modifica di un piano.
Per ogni prova abbiamo usato lo stesso prompt e gli stessi materiali; la ricerca web era consentita soltanto nel Test 1. Abbiamo conservato la prima risposta valida, senza rigenerazioni volontarie. Nel Test 3 Perplexity non ha potuto ricevere l’immagine nell’interfaccia Free usata e il risultato è stato registrato come N/T. Nel Test 4 la prima sessione Gemini, interrotta e non recuperabile, è stata esclusa: abbiamo valutato soltanto il rerun completo.
| Chatbot | Piano e modalità usati nei test |
|---|---|
| ChatGPT | Free, esperienza predefinita; modello non indicato nell’interfaccia |
| Claude | Free, Sonnet 5 in modalità Medio |
| Gemini | Free, Flash |
| Microsoft Copilot | Free, Smart |
| Perplexity | Free, esperienza predefinita; modello non identificato |
Le condizioni descrivono le sessioni provate, non necessariamente l’offerta attuale. Ogni scenario è stato eseguito una volta: sono prove esplorative, non un benchmark statistico, e non abbiamo calcolato medie, voti o una classifica generale.
I test non valutano governance, conservazione dei dati, requisiti contrattuali, controlli amministrativi o altre condizioni enterprise. Con dati aziendali sensibili vanno verificati anche piano, impostazioni, policy e condizioni applicabili all’organizzazione.
I giudizi sono stati sottoposti a due controlli indipendenti: gli assistenti hanno valutato gli output senza vedere il giudizio di ChatGPT, poi li hanno confrontati con l’analisi iniziale. I controlli indipendenti hanno confermato gran parte dell’analisi, ma non tutti i giudizi coincidevano: le divergenze sono state riesaminate sulle evidenze prima di fissare i verdetti finali. Alcuni rilievi intermedi sono stati corretti e l’articolo completo è stato revisionato separatamente.
I prompt integrali dei quattro test sono disponibili in un unico allegato metodologico pubblico.
Test 1: ricerca aggiornata e qualità delle fonti
Nel primo test, il titolare di una piccola azienda italiana B2B poteva dedicare al massimo due giornate a un evento tech nel 2026. I chatbot dovevano confrontare Wave by Vento, Maker Faire Rome e SMAU Milano per date, pubblico, networking, workshop, tecnologia e AI, usando fonti ufficiali aggiornate e distinguendo fatti e interpretazioni.
Consulta il prompt integrale del Test 1.
Tutti e cinque hanno consigliato SMAU Milano. L’edizione 2026 è prevista il 3 e 4 novembre ad Allianz MiCo; le pagine ufficiali descrivono Startup Safari costruiti sui bisogni di innovazione delle aziende, oltre 50 workshop, networking e un posizionamento esplicito su startup e Open Innovation. (SMAU Milano 2026; save the date; Startup Safari)
| Chatbot | Risultato decisivo |
|---|---|
| ChatGPT | Buona priorità alle fonti ufficiali e distinzione più netta tra fatti e interpretazioni; la risposta è stata però più lunga del necessario e ha aggiunto punteggi non richiesti |
| Claude | È stato sintetico e orientato alla scelta, ma ha qualificato meno bene alcuni numeri storici e ha formulato una conclusione troppo forte sul matching di SMAU |
| Gemini | Chiaro il collegamento tra eventi ed esigenze dell’azienda; il limite è stato l’uso di formulazioni troppo assolute come 100% B2B e di riferimenti non dimostrati alla densità dei decisori |
| Microsoft Copilot | Ha raggiunto una raccomandazione coerente, ma ha richiesto più verifiche e ha inserito un passaggio incoerente sul matching strutturato |
| Perplexity | Ha organizzato bene il confronto e mostrato molte citazioni, ma una fonte associata a SMAU non era allineata all’edizione corrente |
Un’assenza di evidenza non autorizza una conclusione categorica. Per Maker Faire Rome, nelle fonti ufficiali consultate non abbiamo trovato un sistema di business matching chiaramente comparabile a quelli documentati da SMAU e Wave. L’evento prevede comunque opportunità di networking tra aziende, startup, istituzioni, ricercatori e investitori, quindi non sarebbe corretto concludere che manchino occasioni strutturate di incontro. Wave 2026 è un evento di tre giorni, con masterclass e un’area networking che permette di prenotare incontri 1:1 tramite l’app ufficiale, mentre Maker Faire Rome 2026 si presenta come evento pubblico dedicato a tecnologia, creatività e innovazione applicata, con esposizioni, workshop e talk. (Wave: informazioni evento; Wave: pass e networking; Maker Faire Rome 2026; Maker Faire Rome: networking)
Verdetto del Test 1: ChatGPT ha prodotto il risultato più convincente perché ha gestito meglio fonti, temporalità e incertezza. Claude e Perplexity sono rimasti competitivi, mentre alcune affermazioni di Gemini e Copilot avrebbero richiesto più controlli prima di essere usate in una decisione reale.
La prova mostra un limite importante della ricerca con i chatbot: accesso al web e citazioni visibili non bastano. È ancora necessario verificare che la fonte sia aggiornata e sostenga davvero l’affermazione a cui viene collegata.
Test 2: trasformare appunti disordinati in azioni
Nel secondo scenario abbiamo fornito appunti con correzioni, proposte non approvate e responsabilità già assegnate: pilot ridotto da 15 a 10 clienti, nuova data di partenza, budget corretto a massimo 3.600 euro e FAQ passate da Marco a Elena. Il compito era ricostruire le decisioni, separando aggiornamento per il team, attività assegnate e questioni aperte.
Consulta i materiali e il prompt del Test 2.
| Chatbot | Risultato osservato |
|---|---|
| ChatGPT | Sei task, responsabili e scadenze sono stati recuperati correttamente; il video tutorial è però finito tra i punti aperti nonostante fosse già escluso dal pilot |
| Perplexity | Ha ricostruito le sei attività e mantenuto il budget come limite massimo, commettendo lo stesso errore di classificazione sul video tutorial |
| Microsoft Copilot | Ha riportato sei task corretti senza inventare responsabili, ma ha trattato il tetto di 3.600 euro come budget definitivo e inserito il video tra i punti aperti |
| Gemini | Ha gestito bene le correzioni e non ha inventato responsabili, ma ha aggiunto nella tabella il bilancio del 30 settembre, non assegnato a nessuno |
| Claude | Quasi tutta la ricostruzione era corretta; l’errore è stato assegnare a Laura il bilancio del 30 settembre soltanto perché aveva proposto quella data |
L’errore di Claude era il più rischioso: proporre una data non equivale ad assumersi la responsabilità di un’attività. In questo scenario la qualità decisiva era non trasformare proposte, correzioni o associazioni in decisioni che nessuno aveva preso.
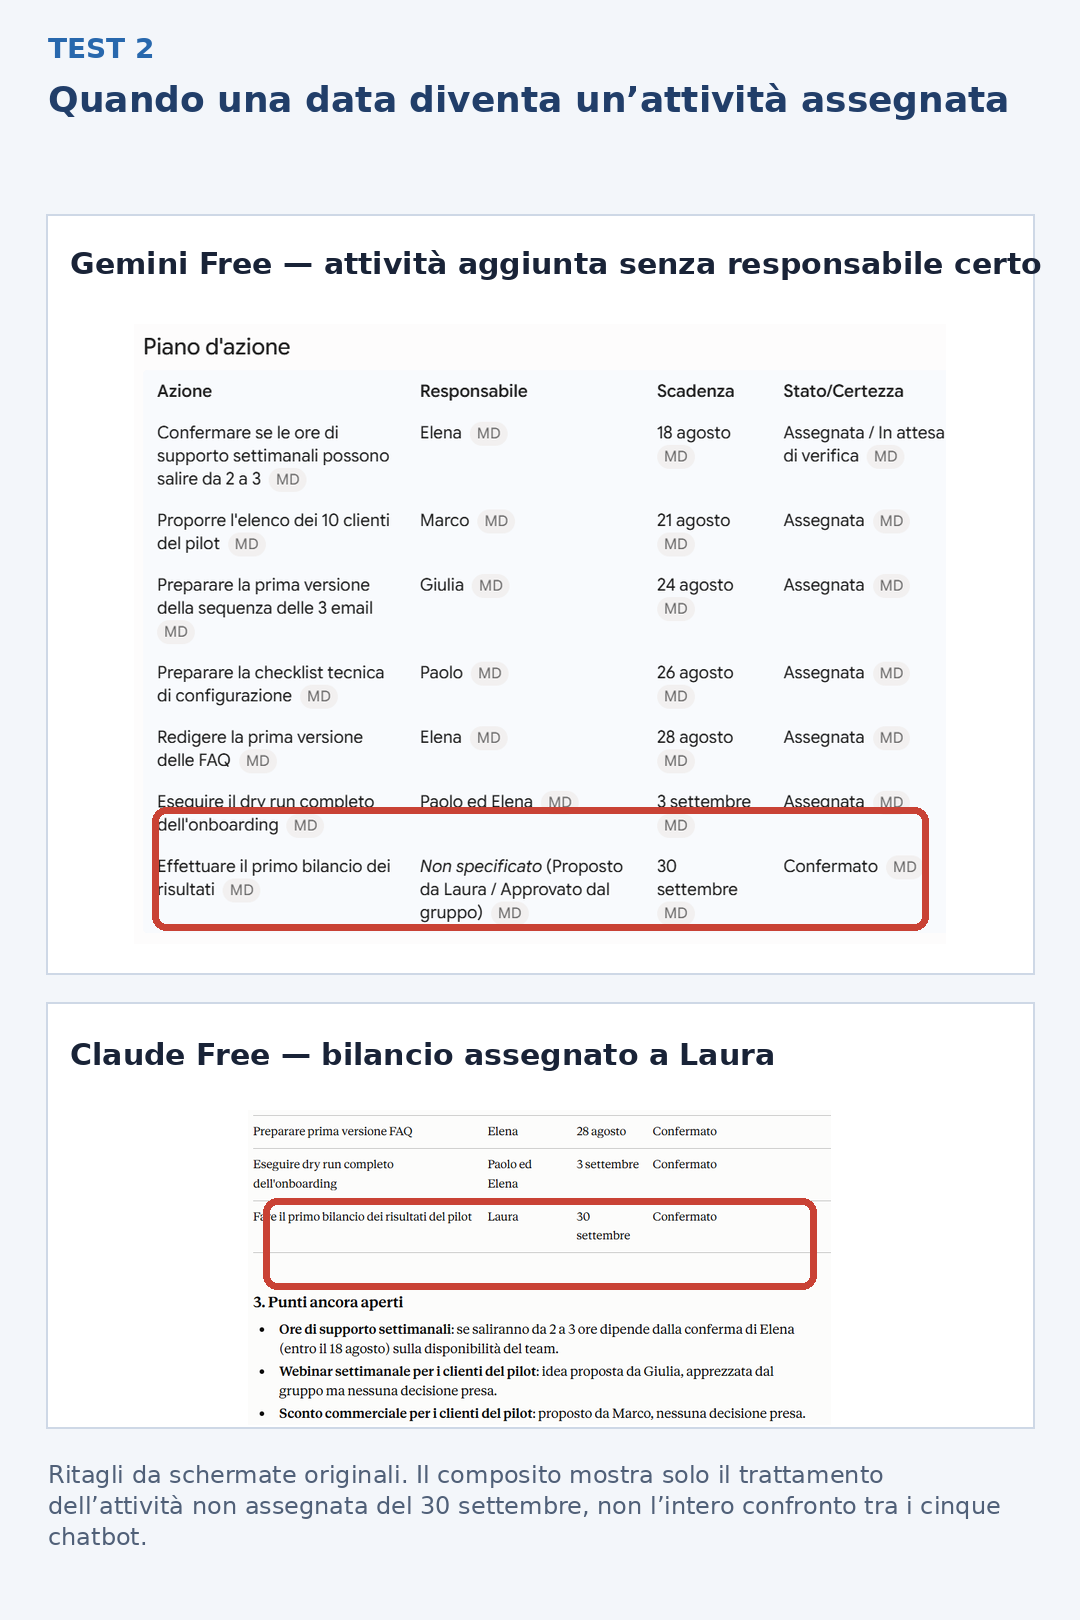
Gemini e Claude hanno trasformato il bilancio del 30 settembre in un’attività assegnata, anche se negli appunti era stata approvata soltanto la data del primo bilancio.
Verdetto del Test 2: ChatGPT e Perplexity hanno prodotto i risultati più convincenti. Entrambi hanno ricostruito correttamente il piano e richiesto soltanto una correzione sulla classificazione del video tutorial. Copilot è rimasto vicino; Gemini ha aggiunto un’attività non assegnata e Claude ha introdotto un responsabile inesistente.
Test 3: capire una lavagna di lavoro
Nel terzo test abbiamo fornito una lavagna con 11 attività, responsabili, date, stati, correzioni, elementi barrati e collegamenti. Il chatbot doveva distinguere informazioni esplicite, relazioni disegnate e dipendenze certe. Comparivano la sequenza visuale 3 → 7 → 11, la dipendenza esplicita del task 10 dal task 9 e un collegamento rosso deliberatamente ambiguo.
Consulta il prompt integrale del Test 3.
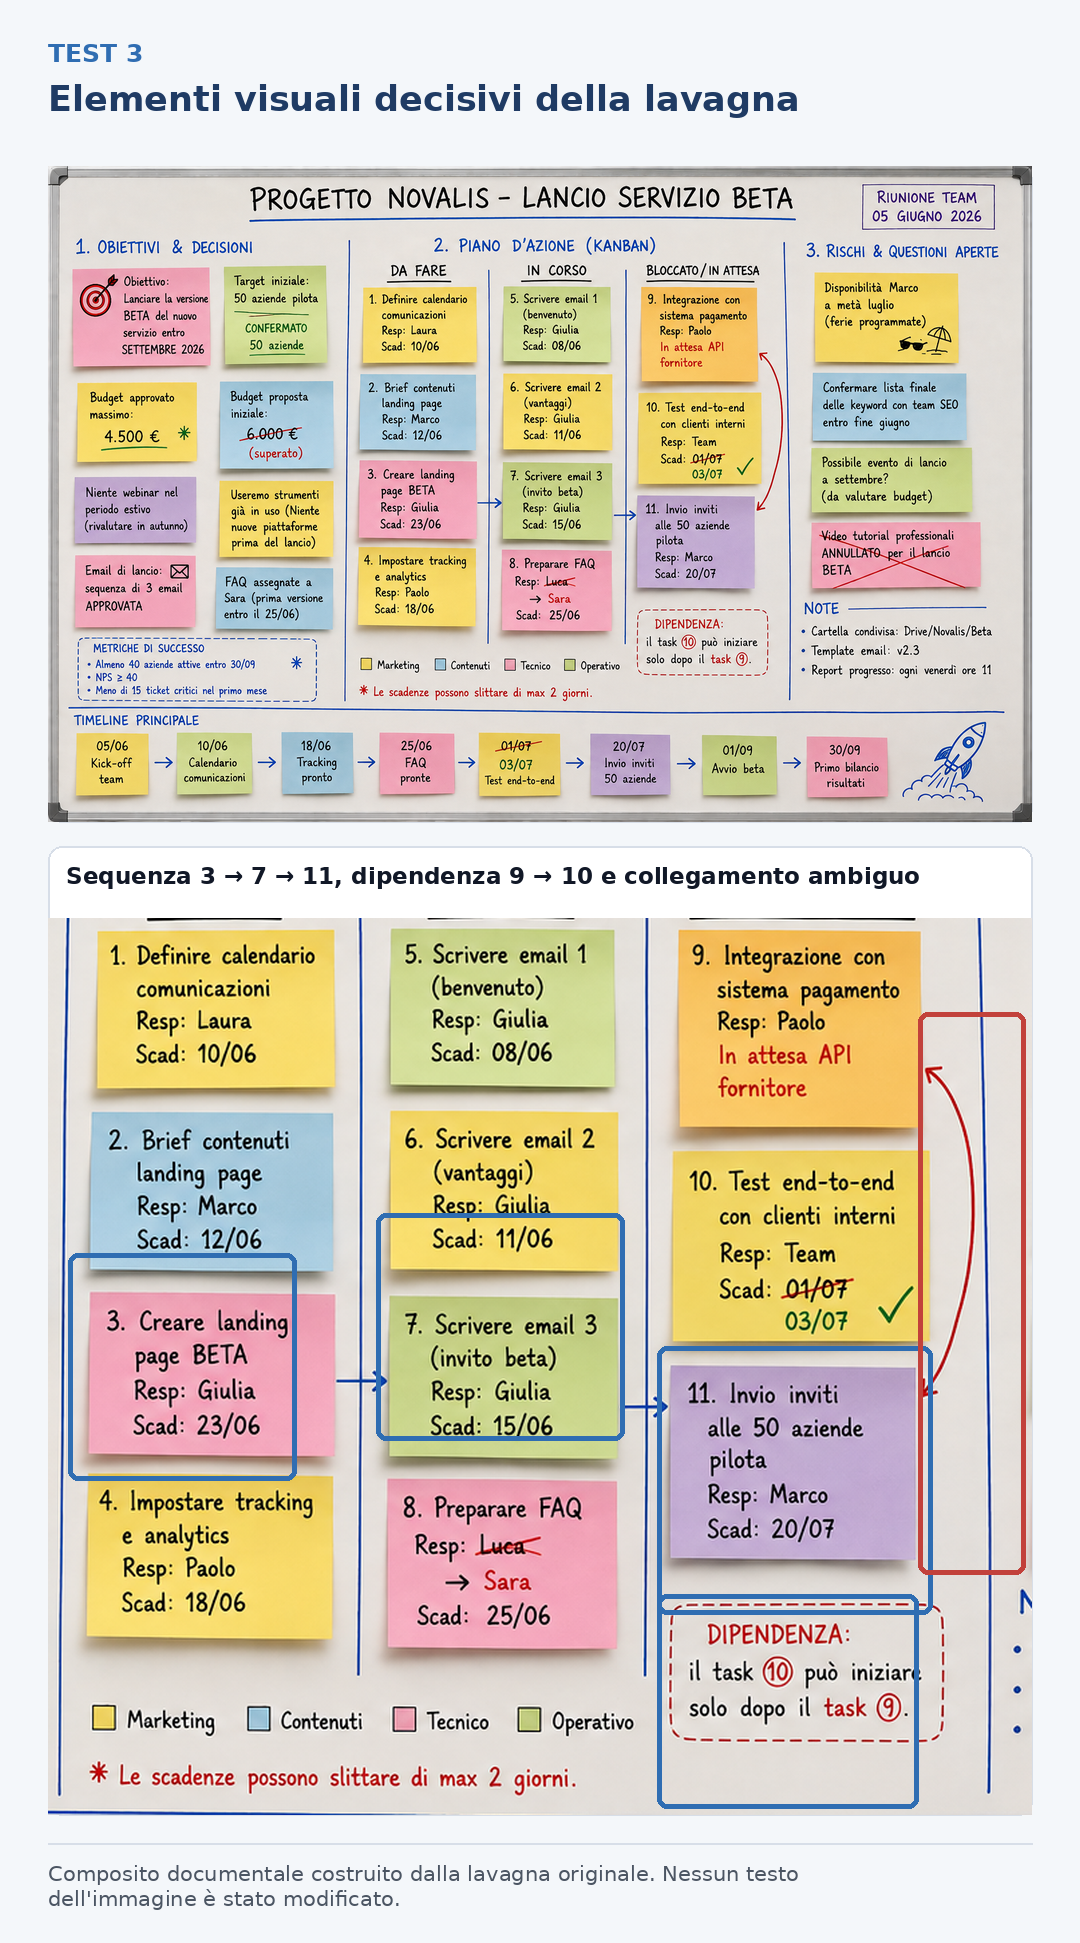
Il Test 3 richiedeva di leggere task, correzioni e relazioni visuali senza trasformare un collegamento ambiguo in una dipendenza certa.
| Chatbot | Risultato osservato |
|---|---|
| Gemini | Corretta la lettura degli 11 task, della dipendenza 9 → 10 e della relazione 3 → 7 → 11, senza trasformare quest’ultima in un blocco operativo non dichiarato |
| ChatGPT | Ha ricostruito correttamente task, responsabili, date e stati; ha riconosciuto 9 → 10 e trattato con prudenza il collegamento ambiguo, ma non ha esplicitato la sequenza 3 → 7 → 11 |
| Claude | Ha letto correttamente le informazioni principali ed è rimasto prudente sulle relazioni ambigue, ma non ha esplicitato la sequenza blu completa |
| Microsoft Copilot | Il task 7 è stato attribuito a Team invece che a Giulia; inoltre sono state omesse parte delle relazioni visuali ed è comparsa un’inferenza non sufficientemente sostenuta nell’area ambigua |
| Perplexity | N/T: nell’interfaccia Free usata durante la prova non era disponibile il caricamento dell’immagine |
Verdetto del Test 3: Gemini ha prodotto il risultato più convincente. Ha recuperato più informazioni visuali rilevanti senza trasformare gli elementi ambigui in fatti certi. ChatGPT e Claude sono rimasti solidi; Copilot ha richiesto una correzione sul responsabile di un’attività.
Il risultato vale per questa lavagna e non dimostra che Gemini sia universalmente migliore con qualsiasi immagine. Perplexity resta N/T perché, nelle condizioni della prova, non potevamo fornirgli lo stesso input visuale. La documentazione ufficiale aggiornata a luglio 2026 indica però che Perplexity supporta oggi anche immagini, audio e video come allegati: è un’informazione sul prodotto corrente, distinta da ciò che abbiamo effettivamente osservato nella sessione di test. (File Uploads di Perplexity)
Test 4: adattarsi a requisiti che cambiano
L’ultima prova chiedeva di aggiornare senza ricominciare da zero il piano di lancio di un servizio SaaS B2B. Nel primo turno i vincoli erano: budget massimo di 12.000 euro; LinkedIn Ads, email e webinar come soli canali; limiti di ore per marketing e design; massimo 25 chiamate commerciali al giorno; data di lancio fissa; pagina prodotto esistente; nessuno sconto; trial di 14 giorni.
Nel secondo turno cambiavano soltanto due requisiti: budget ridotto del 25%, da 12.000 a 9.000 euro, e webinar non più disponibile. L’istruzione decisiva era modificare soltanto ciò che serviva.
Consulta il prompt integrale del Test 4.
| Chatbot | Risultato osservato |
|---|---|
| ChatGPT | Webinar rimosso, budget portato a 9.000 euro e altri vincoli mantenuti senza reinventare il piano |
| Claude | Ha aggiornato il secondo turno in modo disciplinato; nel piano iniziale aveva però introdotto supporto grafico esterno non previsto e tratto conclusioni troppo sicure sulla capacità commerciale |
| Gemini | Ha eseguito un secondo turno corretto e selettivo; nel primo aveva dichiarato un totale di 11.500 euro per voci che sommavano 12.000 euro |
| Microsoft Copilot | Ha conservato i vincoli principali, ma nel secondo turno ha aggiunto attività di compensazione non necessarie |
| Perplexity | Più modifiche del necessario: attività organiche su LinkedIn, sequenza email ampliata e KPI e benchmark quantitativi non presenti nei dati |
ChatGPT non era partito da un piano perfetto: nel primo turno aveva scritto che Marta e Davide disponevano complessivamente di 40 ore alla settimana, mentre i limiti indicati erano 20 e 8 ore. Gemini aveva invece sommato correttamente le voci a 12.000 euro, ma stampato un totale di 11.500; nel secondo turno il nuovo totale di 9.000 euro era corretto.
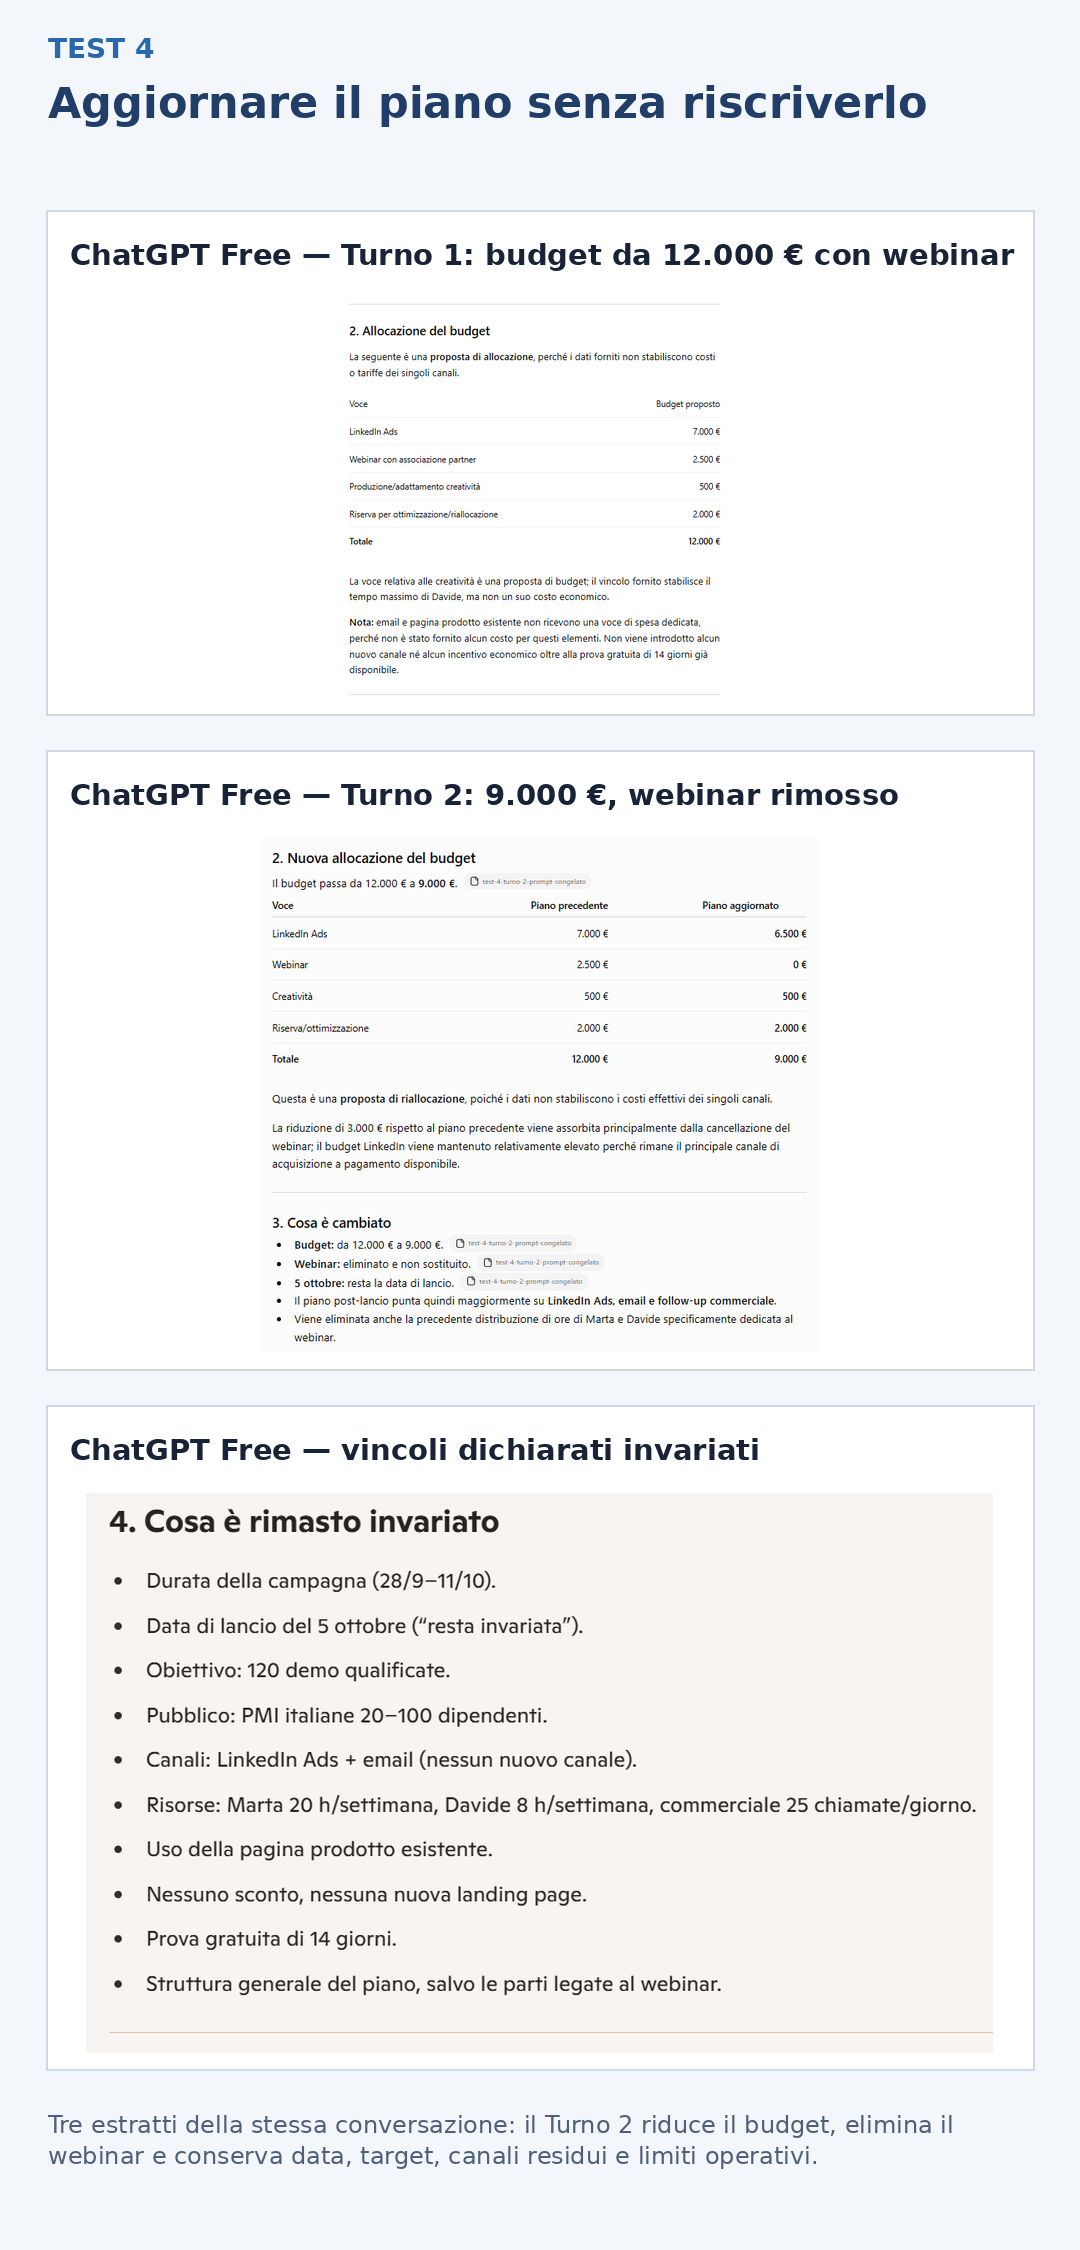
Nel Turno 2 ChatGPT ha ridotto il budget, eliminato il webinar e mantenuto data di lancio, target, canali residui e limiti operativi. Estratti dalla stessa conversazione.
Verdetto del Test 4: ChatGPT ha prodotto il risultato più convincente nel passaggio di adattamento del secondo turno, perché ha modificato il piano in modo selettivo e preservato meglio le condizioni rimaste valide. Questo non cancella l’errore del primo turno sulle ore complessive disponibili, che resta un limite concreto da considerare. Claude e Gemini si sono comportati bene nell’aggiornamento, ma partivano anch’essi da imprecisioni; Copilot e soprattutto Perplexity hanno aggiunto più soluzioni di quelle richieste.
Cosa emerge dai quattro test
| Test | Risultato più convincente |
|---|---|
| Ricerca aggiornata e fonti | ChatGPT |
| Appunti disordinati trasformati in azioni | ChatGPT e Perplexity |
| Comprensione della lavagna visuale | Gemini |
| Cambio di requisiti | ChatGPT |
Nel campione osservato ChatGPT è stato il chatbot più consistente nel complesso. Il punto non è il numero di prove “vinte”, ma la continuità mostrata tra ricerca, lavoro operativo, input visuale e cambio di requisiti. Questo non equivale a definirlo il miglior chatbot AI del 2026: ogni scenario è stato eseguito una volta, sulle versioni Free disponibili durante le prove, e la conclusione riguarda soltanto la consistenza osservata in questi quattro casi.
Quale chatbot scegliere nel 2026
ChatGPT: la scelta più trasversale
ChatGPT è il candidato più naturale per chi vuole usare un solo chatbot in attività diverse. Il piano Free documenta ricerca web, analisi dati, upload di file e immagini e generazione di immagini. La memoria è disponibile anche sul Free, ma capacità e rollout possono variare per piano e account; i piani a pagamento offrono limiti più alti e, a seconda del piano, accesso più ampio a modelli e modalità. (ChatGPT Free; memoria)
Nei quattro test è stato il prodotto più uniforme, anche se ha commesso errori: la sua forza nel campione non è stata la perfezione, ma la capacità di restare competitivo in scenari molto diversi. Se vuoi partire dalle basi prima del confronto, trovi anche la nostra guida su cos’è ChatGPT e come usarlo nel 2026.
| Pro | Limiti |
|---|---|
|
|
Ideale per: professionisti e PMI che cercano un assistente generalista.
Gemini: per multimodalità e servizi Google
Gemini è particolarmente interessante quando il materiale di partenza non è soltanto testo. Google documenta upload di documenti, immagini, video e audio, oltre al collegamento con Gmail, Drive, Docs, Calendar, Keep e Tasks. (file e media; Google Workspace)
Nel Test 3 ha interpretato la lavagna meglio degli altri prodotti effettivamente provati. Per capire meglio funzioni, limiti e uso quotidiano puoi partire dalla guida Gemini AI: cos’è, come funziona e come usarlo nel 2026. Se invece il dubbio principale è proprio tra i due assistenti più generalisti del confronto, abbiamo analizzato separatamente Gemini vs ChatGPT.
| Pro | Limiti |
|---|---|
|
|
Ideale per: chi lavora molto in Google Workspace o usa immagini, audio e video.
Claude: per documenti e lavoro continuativo
Claude offre un perimetro ampio per testi, documenti e file. Anthropic documenta upload di documenti e immagini, memoria anche nel Free, connettori Google Workspace e creazione diretta di file come DOCX, XLSX, PPTX e PDF tramite code execution. (upload; memoria; Workspace; creazione file)
Nei test ha prodotto risposte spesso concise e ben organizzate, ma nel Test 2 ha trasformato una proposta di data nell’assegnazione di un responsabile. Per funzioni, interfaccia e utilizzo quotidiano puoi approfondire nella guida Claude AI: cos’è, come funziona e come usarlo nel 2026.
| Pro | Limiti |
|---|---|
|
|
Ideale per: scrittura, revisione, PDF, documentazione e progetti continuativi.
Microsoft Copilot: soprattutto dentro Microsoft 365
Microsoft Copilot è disponibile gratuitamente per domande, scrittura e attività basate sul web; con un account personale connesso aggiunge funzioni come cronologia, conversazioni più lunghe, voce e creazione di immagini. Supporta inoltre il caricamento di PDF, DOCX, XLSX, PPTX e altri formati. La proposta cambia quando Copilot entra nelle app Microsoft 365 come Word, Excel, PowerPoint e Outlook. (Copilot Free; file; Microsoft 365)
Nei nostri test ha conservato spesso la direzione generale corretta, ma ha richiesto più controllo umano sui dettagli.
| Pro | Limiti |
|---|---|
|
|
Ideale per: professionisti e aziende che lavorano già ogni giorno in Microsoft 365.
Perplexity: quando la ricerca viene prima di tutto
Perplexity si presenta come motore di ricerca AI: cerca sul web, sintetizza le informazioni e mostra citazioni con link alle fonti originali. (fonte)
Nel Test 1 ha organizzato bene il confronto e mostrato molte fonti, ma almeno una non sosteneva il dato corrente a cui era collegata. Nel Test 2 è stato nel gruppo più convincente.
| Pro | Limiti |
|---|---|
|
|
Ideale per: ricerca web, fonti e prima esplorazione di un argomento.
Quando basta il Free e quando valutare un piano a pagamento
Tutti e cinque i chatbot permettono di iniziare gratuitamente, e i test Volvren sono stati svolti sui livelli Free disponibili durante le prove. (ChatGPT Free; Gemini senza piano AI; Claude Free; Copilot Free; Perplexity Standard)
Per un uso occasionale conviene iniziare dal piano gratuito e provare lo stesso compito abituale su due o tre chatbot, osservando qualità dell’output, correzioni necessarie e limiti incontrati. Per ChatGPT abbiamo anche un confronto dedicato tra Free e Plus con test pratici.
Il passaggio a pagamento ha più senso quando cambia almeno uno di questi fattori:
- raggiungi spesso i limiti del piano gratuito;
- ti serve l’accesso a modelli o modalità più avanzate;
- lavori con più file, documenti più lunghi o maggiori quantità di media;
- vuoi integrare il chatbot nella suite che usi ogni giorno;
- la ricerca approfondita o la scelta tra modelli è una parte frequente del lavoro.
Quote, funzioni e differenze tra piani cambiano nel tempo: prima di acquistare vanno ricontrollate sulle fonti ufficiali aggiornate. (ChatGPT; Gemini; Claude; Microsoft 365; Perplexity)
Altri chatbot AI da conoscere
Grok, Meta AI, Vibe e DeepSeek non sono stati sottoposti allo stesso protocollo dei cinque prodotti principali, quindi li citiamo senza collocarli sopra o sotto i chatbot testati. Grok è l’assistente di xAI e documenta chat, voce, upload di file e generazione di immagini e video; Meta AI è disponibile in Europa nei servizi Meta come Facebook, Instagram, WhatsApp e Messenger; Vibe è il nuovo nome di Le Chat e Mistral lo presenta come agente unificato con modalità Work, Code e Chat; DeepSeek offre gratuitamente chat, ricerca web, modalità Deep-Think e upload di file nella propria app. (Grok; Meta AI; Vibe; DeepSeek)
Quale sceglierei in base al profilo
Se non hai un’esigenza dominante, partirei da ChatGPT, il più consistente nei quattro scenari. Sceglierei Gemini per servizi Google e contenuti multimodali, Claude per documenti e continuità, Copilot per Microsoft 365 e Perplexity quando la ricerca web viene prima di tutto. In ogni caso, prova sul piano gratuito il compito reale, misura le correzioni necessarie e paga solo quando limiti, integrazioni o funzioni avanzate diventano un ostacolo concreto.